Zähler ohne Tracking: ein Klick, zwei Anfragen
Ausgangslage
Ich wollte wissen, wie oft die Links zu LinkedIn und GitHub angeklickt werden. Der Slogan «ohne Werbung und ohne Tracking» bleibt unverändert.
Die Weiterleitung
Die Links auf LinkedIn und GitHub zeigen auf zwei kurze Pfade meiner eigenen Domain. Der Webserver der Seite antwortet dort mit einer Weiterleitung (HTTP 302) zum Ziel. Die Weiterleitung steht in der Konfiguration des Webservers und ist vom Zählen unabhängig. Fällt das Zählen aus, wird trotzdem weitergeleitet.
Das Zählen
Gezählt wird nachträglich und nicht auf der Seite. Es gibt kein Zählskript im Browser, kein Zählpixel und keinen Drittanbieter. Ein kleines Skript liest das Anfrageprotokoll des Webservers und legt pro Klick eine Zeile in einer Datenbank auf dem Server an. Gezählt werden nur GET-Anfragen auf die beiden Pfade, die mit der Weiterleitung (Status 302) beantwortet wurden, HEAD-Anfragen zählen nicht. Enthält die Browserkennung «bot», «spider» oder «crawl» (Gross-/Kleinschreibung egal), gilt der Klick als «erkanntes Programm», alles andere als «nicht als Programm erkannt». Die Stufe «vermutetes Programm» vergibt das Skript nicht. Sie wurde bis zum Abend des 21. Oktober 2026 (UTC) von Hand vergeben, siehe unten.
Eine Zeile besteht aus Zeitpunkt (UTC), Ziel, Einstufung und den drei Zahlen zum Umfeld des Klicks.
Der Fehler: ein Klick, zwei Anfragen
Die Seite lädt den Seitenwechsel von Astro (ClientRouter). Er fängt Klicks auf Links ab und holt das Ziel zuerst selbst per fetch(). Bei einer Weiterleitung auf eine fremde Domain scheitert das, danach navigiert der Browser normal. Damit sah der Server zwei Anfragen pro Klick: die des fetch() und die der normalen Navigation.
Aufgefallen ist es bei eigenen Testklicks. Pro Klick standen zwei Zeilen mit derselben Browserkennung im Protokoll. Bei LinkedIn lagen die beiden Zeilen höchstens eine Sekunde auseinander, bei GitHub standen sie in derselben Sekunde.
Der Nachweis im Browser
Warum der Abruf scheitert, habe ich in den Entwicklerwerkzeugen nachgestellt. Dazu habe ich in einem Tab bei einem der Links das Attribut data-astro-reload entfernt und den Link angeklickt. Dieser Klick zählt als Testdaten.
Der Netzwerk-Reiter von Safari zeigt den Ablauf:
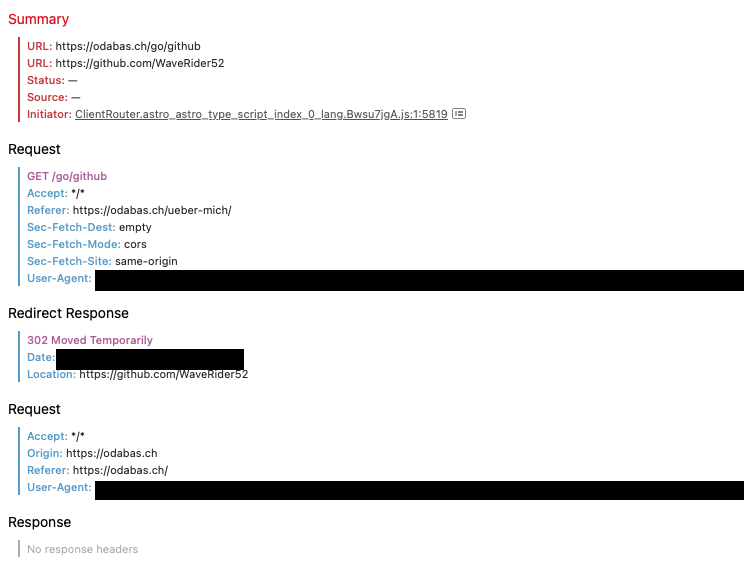
Netzwerk-Reiter in Safari. Browserkennung und Zeitstempel sind ausgeblendet.
- Die erste Anfrage geht an
/go/github. Ihr Initiator ist derClientRouter, ihr Modus istcors. - Mein Webserver antwortet mit der Weiterleitung (302) auf das GitHub-Profil.
- Die Anfrage an GitHub trägt den Header
Origin: https://odabas.ch. Eine Antwort kommt nicht zurück, der Eintrag ist rot und ohne Status. - Danach folgt die zweite Anfrage, die normale Navigation auf die GitHub-Seite.
Den Grund nennt die Konsole. Ich habe denselben Weg aus der Konsole mit einer HEAD-Anfrage nachgestellt, damit der Zähler nichts zählt:
fetch('/go/github', { method: 'HEAD' }).catch(e => console.log('fetch failed:', e.message))Chrome meldet dazu:
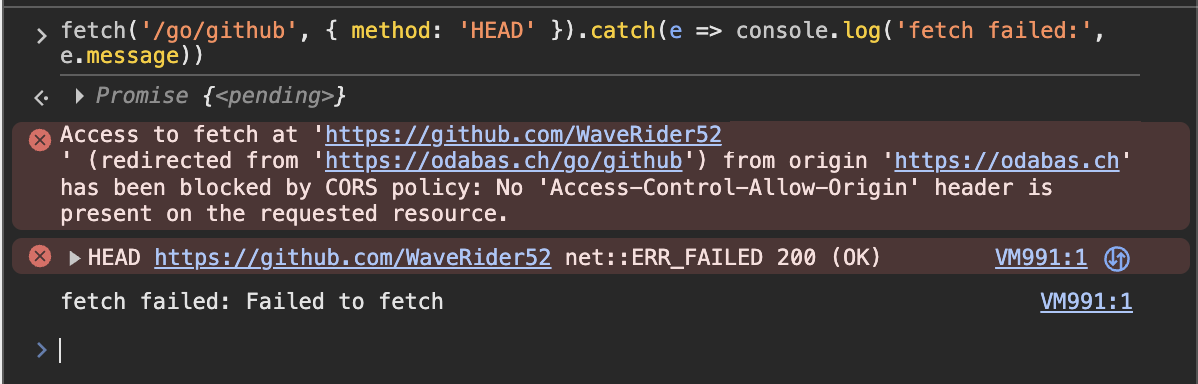
Konsole in Chrome. Die Quellenangabe der Meldung ist ausgeblendet.
Access to fetch at ‘https://github.com/WaveRider52’ (redirected from ‘https://odabas.ch/go/github’) from origin ‘https://odabas.ch’ has been blocked by CORS policy: No ‘Access-Control-Allow-Origin’ header is present on the requested resource.
Safari meldet es mit eigenen Worten: «Origin https://odabas.ch is not allowed by Access-Control-Allow-Origin.»
Ein Blick auf die Antworten im Terminal bestätigt beide Seiten (Ausgabe gekürzt):
$ curl -sI https://odabas.ch/go/github
HTTP/1.1 302 Moved Temporarily
[…]
Location: https://github.com/WaveRider52

$ curl -sI -H 'Origin: https://odabas.ch' https://github.com/WaveRider52
HTTP/2 200
[…]

$ curl -sI -H 'Origin: https://odabas.ch' https://github.com/WaveRider52 | grep -i '^access-control-allow-origin'
# keine Ausgabe
Mein Server leitet korrekt weiter und setzt dabei keinen Cookie. In der Antwort von GitHub fehlt die Zeile access-control-allow-origin. Ohne sie blockiert der Browser den Abruf einer anderen Domain. Das ist CORS, und aus der Vermutung ist damit eine Beobachtung geworden.
Die Korrektur
Alle Links auf die beiden Pfade haben jetzt das Attribut data-astro-reload. Der Seitenwechsel greift dann nicht ein. Eine Prüfung des gebauten Stands fand keinen Link auf die beiden Pfade ohne das Attribut.
Danach ergab ein Klick eine Anfrage, in Safari gemessen. Für andere Browser folgt das aus der Korrektur, ich habe es dort nicht gemessen. Die Daten aus der Fehlerzeit sind Testdaten und fliessen in keine Auswertung.
Was gespeichert wird
Pro Klick speichert der Server den Zeitpunkt (UTC), das Ziel und eine Einstufung («nicht als Programm erkannt», «erkanntes Programm» oder «vermutetes Programm»), dazu drei Zahlen für die 30 Sekunden um den Klick: wie viele verschiedene Seiten dieselbe Browserkennung abgerufen hat, die höchste Zahl von Seitenanfragen in einer Sekunde und wie viele Dateien (Stile, Skripte, Schriften, Bilder) sie angefordert hat. Die Browserkennung selbst steht nicht in der Datenbank, sie liegt nur während der Auswertung im Arbeitsspeicher. In der Datenbank stehen keine Adressen und keine Kennungen einzelner Besucher. Fürs Zählen werden keine Cookies verwendet. Die Weiterleitung setzt keinen Cookie, für beide Pfade geprüft.
Einzelne Klicks bleiben bis zu zwölf Monate gespeichert, danach nur noch Tagessummen. Sicherungskopien auf dem Server bleiben bis zu 14 Tage länger. Öffentlich sind nur Tagessummen pro Ziel und Einstufung. Die Zahlen beginnen am Abend des 19. Oktober 2026 (UTC). Bis zum Abend des 21. Oktober 2026 (UTC) sind es Stundenzahlen ohne Seitenangaben. Für diese Zeit wurde die Einstufung «vermutetes Programm» von Hand nach Auffälligkeiten im Protokoll vergeben, nicht automatisch.
Das Anfrageprotokoll des Webservers schreibt seit dem 17.10.2026 pro Anfrage Zeit, Anfrage, Status, Datenmenge und Browserkennung, ohne Adressen, ohne Benutzernamen und ohne Herkunftsseite. Gelöscht wird es, wenn der Webserver neu erstellt wird, spätestens bei der nächsten Veröffentlichung. Der vorgeschaltete Router führt kein Zugriffsprotokoll. Sein technisches Log kann bei Verbindungsabbrüchen die Adresse der Gegenstelle enthalten; das gehört nicht zum Anfrageprotokoll des Webservers.
Grenzen
Gezählt werden Anfragen, nicht Personen. Zwei Klicks derselben Person zählen doppelt. Bei jeder Veröffentlichung geht das Protokoll bis zu diesem Moment verloren, Klicks seit dem letzten Lauf des Skripts fehlen dann. Klicks während kurzer Ausfälle des vorgeschalteten Routers wären nicht erfasst.
Der Bot-Filter ist grob. Wer sich als Browser ausgibt, wird mitgezählt. Die Einstufung ist eine Schätzung, keine Gewissheit. Die Zahl «nicht als Programm erkannt» kann Programme enthalten, die sich als Browser ausgeben. Die von Hand vergebene Stufe «vermutetes Programm» beruht auf Auffälligkeiten im Protokoll und kann auch einen Menschen treffen. Ein von Hand getippter http://-Aufruf eines der Pfade wird zuerst mit einer dauerhaften Weiterleitung auf https beantwortet. Das Skript zählt erst den folgenden Aufruf über https, also einmal. Die Stundenzahlen bis zum Abend des 21. Oktober 2026 (UTC) konnten beide Anfragen zählen.
Die Zeitstempel sind Serverzeit (UTC). Die Schweizer Ortszeit liegt der Serverzeit voraus, bis zur Zeitumstellung am 25.10.2026 um zwei Stunden, danach um eine. Was der Hoster auf Netzwerkebene mitschreibt, gehört nicht zu dieser Aussage.
Der aktuelle Stand der Klicks
Die Tabelle zeigt, wie oft die Links zu GitHub und LinkedIn angeklickt wurden, nicht, wie oft die Seite besucht wurde. Die Zahlen stammen aus einer Datei, die der Server alle 15 Minuten neu schreibt; sie werden beim Laden der Seite gelesen.
Ein Klick gilt als «erkanntes Programm», wenn die Browserkennung «bot», «spider» oder «crawl» enthält. «Vermutetes Programm» wurde bisher nur von Hand vergeben, für importierte Klicks aus der Zeit der Stundenzahlen. Alles andere heisst «nicht als Programm erkannt». Das bedeutet nicht, dass jeder dieser Klicks von einem Menschen stammt.
| Ziel | nicht als Programm erkannt | erkanntes Programm | vermutetes Programm | Summe |
|---|---|---|---|---|
| GitHub | – | – | – | – |
| – | – | – | – | |
| Gesamt | – | – | – | – |
Gezählt seit (UTC): – Stand der Datei (UTC): –
Zum Schluss
Das bisherige Protokollformat enthielt Felder für Adressen. Bei einem unverschlüsselten Aufruf über http:// gibt der Router die Adresse des Besuchers als Kopfzeile weiter (gemessen am 16.10.2026). Bei https:// reicht er die Verbindung unverändert durch, dort gibt es diese Kopfzeile nicht. Seit dem 17.10.2026 schreibt der Webserver keine Adresse mehr ins Protokoll. Ich habe die Aussage gegen das System geprüft, diesen Unterschied gefunden und das Format auf das beschränkt, was Zähler und Fehlersuche brauchen.